数据湖基础
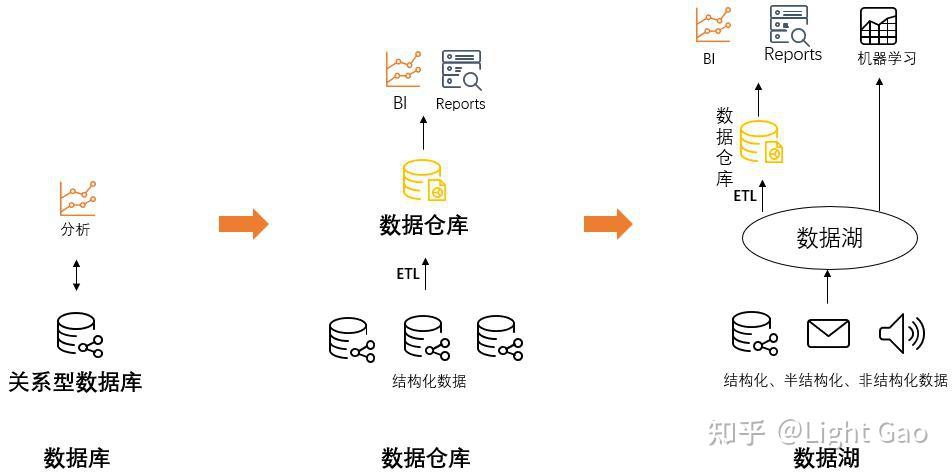
数据仓库、数据湖和湖仓一体是大数据技术发展的三个阶段。数据仓库像结构严密的“精品超市”,主要处理结构化数据以供BI报表使用;数据湖像包罗万象的“大杂货铺”,能低成本存入所有格式的原始数据;湖仓一体则是结合两者的“新一代融合平台”,在一套低成本存储上同时实现灵活存取与高效治理。
数据湖是一种在系统或存储库中以自然格式存储数据的方法,它有助于以各种模式和结构形式配置数据,通常是对象块或文件。数据湖的主要思想是对企业中的所有数据进行统一存储,从原始数据(源系统数据的精确副本)转换为用于报告、可视化、分析和机器学习等各种任务的目标数据。数据湖中的数据包括结构化数据(关系数据库数据),半结构化数据(CSV、XML、JSON等),非结构化数据(电子邮件,文档,PDF)和二进制数据(图像、音频、视频),从而形成一个容纳所有形式数据的集中式数据存储。
数据湖从本质上来讲,是一种企业数据架构方法,物理实现上则是一个数据存储平台,用来集中化存储企业内海量的、多来源,多种类的数据,并支持对数据进行快速加工和分析。从实现方式来看,目前Hadoop是最常用的部署数据湖的技术,但并不意味着数据湖就是指Hadoop集群。为了应对不同业务需求的特点,MPP数据库+Hadoop集群+传统数据仓库这种“混搭”架构的数据湖也越来越多出现在企业信息化建设规划中。
| 特性 | 数据仓库 | 数据湖 |
|---|---|---|
| 数据 | 结构化、半结构化的数据 | 结构化、半结构化和非结构化的数据 |
| Schema | 写入型Schema:入库前必须定义好数据结构 | 读取型Schema:按需在使用时临时定义结构 |
| 数据处理 | ETL:先提取、转化、加载再存储 | ELT:直接加载原始数据,按需再加工 |
| 查询性能 | 高,适合高并发、复杂报表和快速聚合 | 较低,针对海量大数据探索,需专业引擎 |
| 存储成本 | 较高(高性能存储与优化开销大) | 较低(经济实惠的大规模对象存储) |
数据仓库 (Data Warehouse)
- 核心目标:支持企业日常的商业智能(BI)、报表分析和高层决策。
- 数据类型:主要是经过严格清洗和定义的结构化数据。
- 数据模式:写入时模式(Schema-on-Write),数据入库前必须先转换成规范格式。
- 优势劣势:查询速度极快、数据质量高;但灵活性差,无法处理非结构化数据,且前期建模与ETL成本高。
数据湖 (Data Lake)
- 核心目标:汇聚企业所有来源、所有格式的原始数据,供深度探索与AI训练。
- 数据类型:结构化、半结构化与非结构化数据(如音视频、日志等)。
- 数据模式:读取时模式(Schema-on-Read),数据直接原样存入,读取时才赋予结构。
- 优势劣势:存储成本低、存储类型无限灵活;但缺乏强力的事务和治理,容易演变成杂乱无章的“数据沼泽”。
湖仓一体 (Lakehouse)
- 核心目标:实现一份数据、一套系统同时支持BI分析与AI应用。
- 技术实现:在对象存储上借助开源表格式提供事务与治理能力。
- 优势劣势:兼具湖与仓的优势并减少冗余,但技术栈较新、架构运维较复杂。
- 存储与计算分离:湖仓一体架构采取存储计算分离的设计,这种设计使得存储和计算可以分别根据业务的需求进行独立扩展,无需两者同步增加或减少。这种设计有助于节省资源,并降低了系统的总成本。
- 成本效益:利用低成本的对象存储实现高效益的数据存储,降低了存储成本,并避免了维护多个数据存储系统的成本。
- 数据一致性:提供ACID(原子性、一致性、隔离性、持久性)保证,确保数据写入的一致性,这对于金融、电商等需要高并发、高一致性的场景尤为重要。
- 多种数据源支持:支持多种数据源,包括多个数据湖和多级数据湖的联邦查询能力,能够打破数据孤岛,减少数据搬迁和数据一致性问题。
- 统一元数据管理:支持异构数据的统一元数据管理,实现端到端的数据链路的自动化元数据采集,支持全链路血缘,一键式分析技术、业务、操作元数据详情。
- 高可用性:湖仓一体架构使用云对象存储,具有高可用性和高耐用性。
湖仓一体的架构,最终想要实现的,就是通过把数据湖作为中央存储库,围绕数据湖建立各种提供服务的站点,比如数据仓库,供业务分析和接入B使用;再比如供机器学习用的站点;供大数据处理的站点等等,最终实现随心所欲地使用数据湖中的数据。湖仓一体的架构由存储层和计算层组成,计算层的数据来源于存储层。
存储层主要由三个组件组成——云存储、开放的文件格式(open file format)和开放的表格式(open table format)。
云存储:云存储是一种提供实施数据湖和 Lakehouse 平台所需的高可用性、持久性和可扩展性的服务,可以使用亚马逊的 S3 存储或者阿里云的 OSS 对象存储等云服务商提供的对象存储。公司也可以使用本地 HDFS 存储来实施 Lakehouse,仅使用云对象存储来实现 Lakehouse 是没有必要的。但考虑到成本低、计算与存储分离、易于扩展等特点,建议使用云对象存储作为实现 Lakehouse 的底层基础设施。
元数据层(Hive Metastore、Glue Catalog、统一元数据服务):基于数据湖构建统一的数据平台,提供了统一的元数据管理和数据权限管理。原来分集群建设,导致元数据和用户账号不统一,在数据和权限管理上也带来很大麻烦。如果统一元数据和账号体系的管理,就能更方便的做统一的数据管理和权限管理。用于管理数据湖中的表格信息和元数据,它跟踪每个表格的名称、模式和其他相关信息,提供了数据发现和搜索的功能。
开放的文件格式(Parquet、ORC、Avro、JSON):数据平台可以将不同文件格式的数据存储在云存储中,CSV、JSON 和 XML 等文件格式是最流行的。对于分析平台,最广泛采用的三种文件格式是:Apache Parquet、Apache ORC、Apache AVRO。这几种都是开源的列式存储格式,很多存储和处理应引擎都会兼容这几种存储格式。
开放的表格式(Apache Iceberg、Delta Lake、Apache Hudi):湖仓 Lakehouse 支持多种表存储格式,目前开源社区比较流行的是下边三种:
- Apache Iceberg: 是一种开放表格式,可与基于云的数据湖和 Apache Parquet、Apache AVRO 和 Apache Optimized Row Columnar (ORC) 等开放文件格式一起使用,以实现 Lakehouse 架构。它支持时间回溯、schema 推演和 SQL 查询等功能,使 Lakehouse 的构建更快、更容易。
- Apache Hudi:有助于实现事务数据湖,并可用于为数据湖带来类似数据仓库的功能。它提供 ACID 事务保证、时间回溯和回滚能力以及schema 推演功能。
- Linux 基金会的 Delta Lake:Databricks 将 Delta Lake 作为一个内部项目启动,后来在 Linux 基金会下将其开源。它通常被称为用于构建 Lakehouse 架构的开源存储框架。Delta Lake 为数据湖提供元数据层和 ACID 功能。它还提供时间回溯、schema 推演以及审计跟踪记录等功能。
| Apache Iceberg | Delta Lake | Apache Hudi | |
|---|---|---|---|
| 设计哲学 | 完全引擎中立,解耦计算与存储,把表结构抽象为树状元数据 | 以 Spark 为中心深度优化,由 Databricks 主导,全面拥抱单机/云端生态 | 专注于流式/增量数据处理,强于行级快速 Upsert(更新/插入)与删除 |
| 生态兼容性 | 极佳。对 Spark、Flink、Trino、Presto、Hive 等各引擎支持均等 | Spark生态最强;Presto/Trino/Flink 虽支持但不及 Spark 原生契合 | 强绑定 Spark、Flink,对 Hive/Trino 的读写支持在特定版本有差异 |
| 核心优势 | 隐藏分区细节(Hidden Partitioning),小文件管理及对象存储性能优异 | 写入极快,与 Databricks 商业闭环及 Delta-Sharing 共享生态无缝对接 | 专为实时变更(CDC、Upsert)设计,内置高效索引机制 |
| 底层存储格式 | 支持 Parquet、ORC、Avro | 主要基于 Parquet | 主要基于 Parquet 和 HFile/ORC |
Lakehouse 架构的主要优点之一是其开放性以及可由任何兼容处理引擎直接访问或查询的能力。它不需要任何特定的专有引擎来运行 BI 工作负载或交互式分析。这些计算引擎可以是开源的,也可以是专为 Lakehouse 架构设计的专用商业查询引擎。可以通过Apache Spark、Presto、Trino 和 Hive 等开源计算引擎,进行数据湖数据查询分析。
湖仓一体架构主要是实现“湖里”和“仓里”的数据能够无缝打通,在这个背景下催生出:湖在下,仓在上的立体建设模式,在该架构中,湖仓一体架构主要将数据湖作为中央存储库,将机器学习、数据仓库、日志分析、大数据等技术进行整合,形成一套数据服务环,更好地分析、整合数据,让数据仓库和数据湖中的数据可以自由流动,用户可以更便捷地调取其中的数据,让数据“入湖”、“出湖”更为便捷。
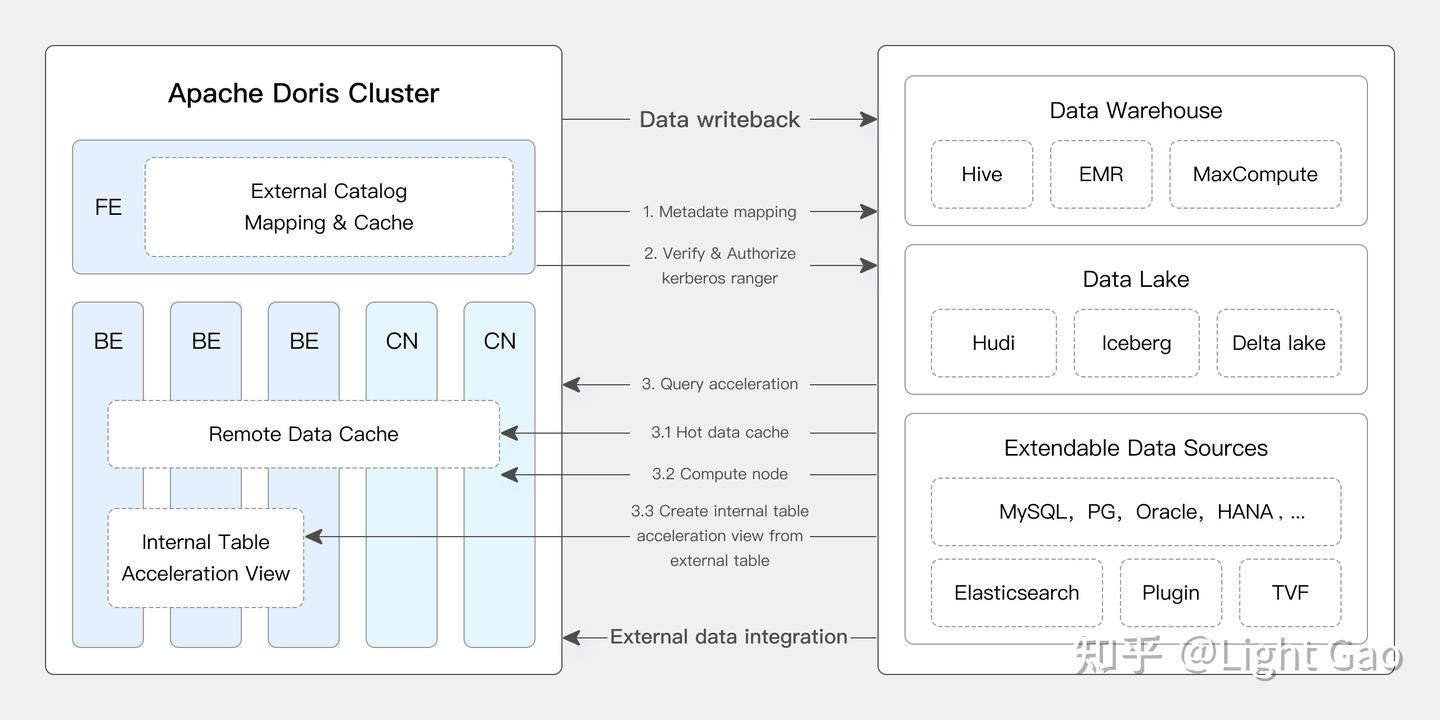
仓外挂湖是指以 MPP 数据库为数仓基础,使用可插拔架构,通过开放接口对接外部数据湖实现统一存储,在存储底层共享一份数据,计算、存储完全分离(即:数据存储在数据湖中,表的元数据管理和计算则使用MPP库能力),实现从强管理到兼容开放存储和多引擎。代表产品: Doris、AWS Redshift、阿里云 MaxCompute/Hologres 湖仓一体。
这里以Doris2.x版本为例,Doris 通过多源数据目录(Multi-Catalog)功能,支持了包括 Apache Hive、Apache Iceberg、Apache Hudi、Apache Paimon(Incubating)等主流数据湖的连接访问。具体架构如下:
下图展示了火山引擎的湖仓一体架构,涵盖从数据存储到计算处理的各个层级:
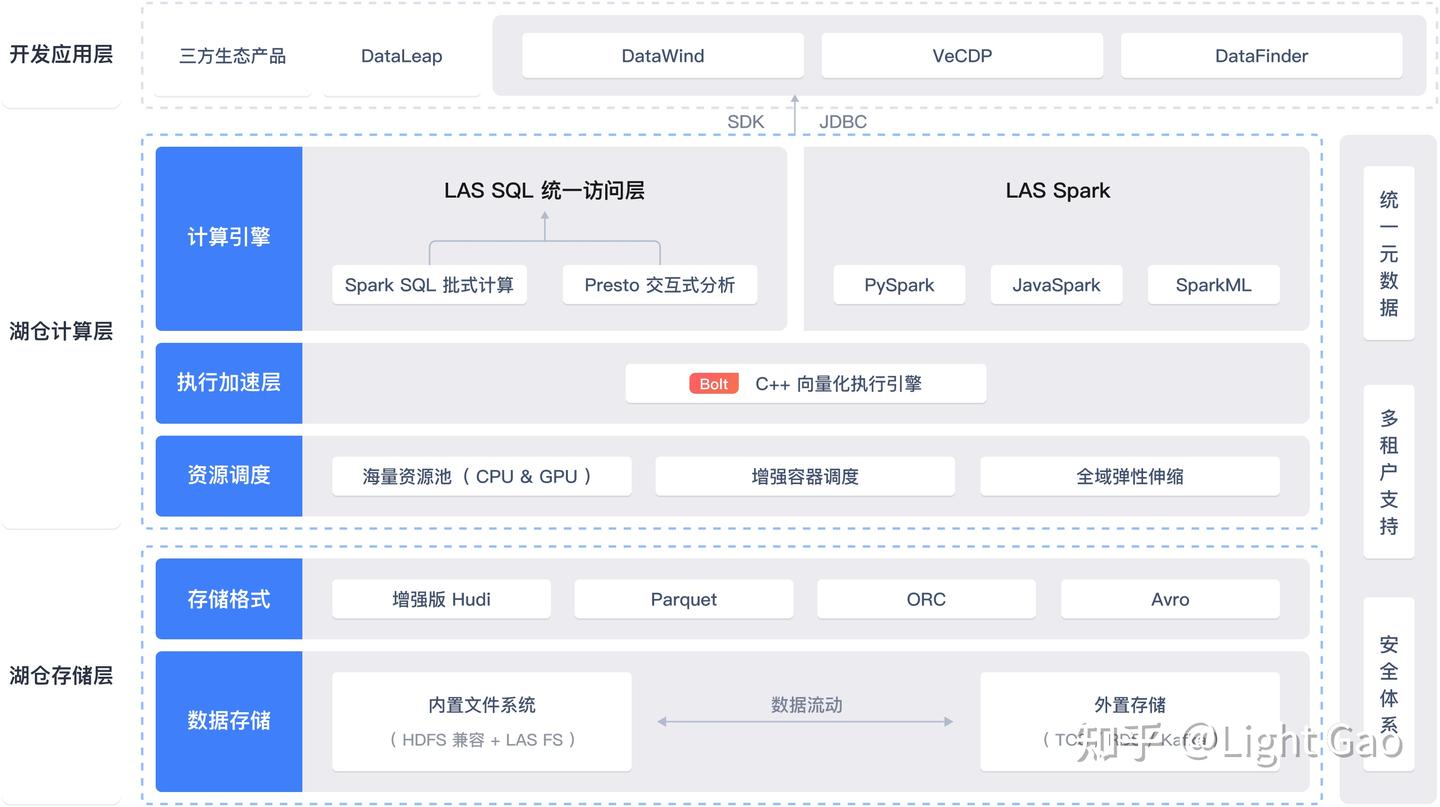
开发应用层:
- 包含第三方生态产品和内部应用(如 DataLeap、DataWind)。
- 通过 SDK 和 JDBC 与计算层交互。
湖仓计算层
- 计算引擎:支持 Spark SQL、Presto、PySpark 等多种计算方式。
- 执行加速层:使用(C++ 向量化执行引擎)(例如Doris、ClickHouse等MPP库) 提高计算性能。
- 资源调度:提供海量资源池和弹性伸缩能力。
湖仓存储层
- 存储格式:支持 Hudi、Parquet、ORC 和 Avro 等格式。
- 数据存储:结合内置文件系统和外置存储(如 TOS、RDS、Kafka)。
数据管理
- 统一元数据管理:确保一致的数据视图。
- 多租户支持:实现数据隔离和管理。
- 安全体系:保障数据安全。
登录后可以选中正文添加批注(仅自己可见)。
评论 (0)
登录后参与评论。
还没有评论,来做第一个。