MapReduce
MapReduce是一个分布式运算程序的编程框架,是用户开发“基于hadoop的数据分析应用”的核心框架;Mapreduce核心功能是将用户编写的业务逻辑代码和自带默认组件整合成一个完整的分布式运算程序,并发运行在一个hadoop集群上。
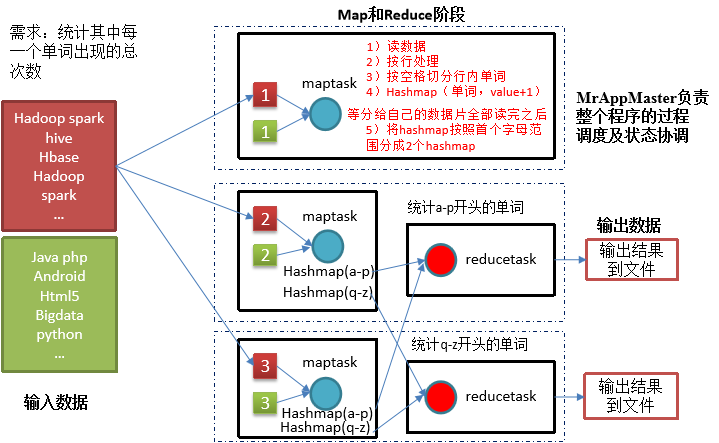
分布式的运算程序往往需要分成至少2个阶段。
- 第一个阶段的MapTask并发实例,完全并行运行,互不相干。
- 第二个阶段的ReduceTask并发实例互不相干,但是他们的数据依赖于上一个阶段的所有MapTask并发实例的输出。
MapReduce编程模型只能包含一个Map阶段和一个Reduce阶段,如果用户的业务逻辑非常复杂,那就只能多个MapReduce程序,串行运行。
Job提交流程源码和切片源码详解\
(1)Job提交流程源码详解
| 1 | waitForCompletion() |
| 2 | submit(); |
| 3 | |
| 4 | // 1建立连接 |
| 5 | connect(); |
| 6 | // 1)创建提交Job的代理 |
| 7 | new Cluster(getConfiguration()); |
| 8 | //(1)判断是本地yarn还是远程 |
| 9 | initialize(jobTrackAddr, conf); |
| 10 | // 2 提交job |
| 11 | submitter.submitJobInternal(Job.this, cluster) |
| 12 | // 1)创建给集群提交数据的Stag路径 |
| 13 | Path jobStagingArea = JobSubmissionFiles.getStagingDir(cluster, conf); |
| 14 | // 2)获取jobid ,并创建Job路径 |
| 15 | JobID jobId = submitClient.getNewJobID(); |
| 16 | // 3)拷贝jar包到集群 |
| 17 | copyAndConfigureFiles(job, submitJobDir); |
| 18 | rUploader.uploadFiles(job, jobSubmitDir); |
| 19 | // 4)计算切片,生成切片规划文件 |
| 20 | writeSplits(job, submitJobDir); |
| 21 | maps = writeNewSplits(job, jobSubmitDir); |
| 22 | input.getSplits(job); |
| 23 | // 5)向Stag路径写XML配置文件 |
| 24 | writeConf(conf, submitJobFile); |
| 25 | conf.writeXml(out); |
| 26 | // 6)提交Job,返回提交状态 |
| 27 | status = submitClient.submitJob(jobId, submitJobDir.toString(), job.getCredentials()); |
(2)FileInputFormat切片源码解析(input.getSplits(job))\
(1)找到你数据存储的目录。\
(2)开始遍历处理(规划切片)目录下的每一个文件\
(3)遍历第一个文件ss.txt\
a)获取文件大小fs.sizeOf(ss.txt);\
b)计算切片大小\
computeSliteSize(Math.max(minSize,Math.max(maxSize,blocksize)))=blocksize=128M\
c)默认情况下,切片大小=blocksize\
d)开始切,形成第1个切片:ss.txt—0:128M 第2个切片ss.txt—128:256M 第3个切片ss.txt—256M:300M\
(每次切片时,都要判断切完剩下的部分是否大于块的1.1倍,不大于1.1倍就划分一块切片)\
e)将切片信息写到一个切片规划文件中\
f)整个切片的核心过程在getSplit()方法中完成。\
g)数据切片只是在逻辑上对输入数据进行分片,并不会再磁盘上将其切分成分片进行存储。InputSplit只记录了分片的元数据信息,比如起始位置、长度以及所在的节点列表等。\
h)注意:block是HDFS上物理上存储的存储的数据,切片是对数据逻辑上的划分。\
(4)提交切片规划文件到yarn上,yarn上的MrAppMaster就可以根据切片规划文件计算开启maptask个数。
(3)FileInputFormat切片机制\
1、默认切片机制\
(1)简单地按照文件的内容长度进行切片\
(2)切片大小,默认等于block大小\
(3)切片时不考虑数据集整体,而是逐个针对每一个文件单独切片\
切片主要由这几个值来运算决定\
mapreduce.input.fileinputformat.split.minsize=1 默认值为1\
mapreduce.input.fileinputformat.split.maxsize= Long.MAXValue 默认值Long.MAXValue\
因此,默认情况下,切片大小=blocksize。\
maxsize(切片最大值):参数如果调得比blocksize小,则会让切片变小,而且就等于配置的这个参数的值。\
minsize(切片最小值):参数调的比blockSize大,则可以让切片变得比blocksize还大。
1)数据切片与MapTask并行度决定机制\
(1)一个job的map阶段并行度由客户端在提交job时决定\
(2)每一个split切片分配一个mapTask并行实例处理\
(3)默认情况下,切片大小=blocksize\
(4)切片时不考虑数据集整体,而是逐个针对每一个文件单独切片
2)MapTask工作机制

(1)Read阶段:MapTask通过用户编写的RecordReader,从输入InputSplit中解析出一个个key/value。\
(2)Map阶段:该节点主要是将解析出的key/value交给用户编写map()函数处理,并产生一系列新的key/value。\
(3)Collect收集阶段:在用户编写map()函数中,当数据处理完成后,一般会调用OutputCollector.collect()输出结果。在该函数内部,它会将生成的key/value分区(调用Partitioner),并写入一个环形内存缓冲区中。\
(4)Spill阶段:即\\“溢写”\\,当环形缓冲区满后,MapReduce会将数据写到本地磁盘上,生成一个临时文件。需要注意的是,将数据写入本地磁盘之前,先要对数据进行一次本地排序,并在必要时对数据进行合并、压缩等操作。\
溢写阶段详情:\
步骤1:利用快速排序算法对缓存区内的数据进行排序,排序方式是,先按照分区编号partition进行排序,然后按照key进行排序。这样,经过排序后,数据以分区为单位聚集在一起,且同一分区内所有数据按照key有序。\
步骤2:按照分区编号由小到大依次将每个分区中的数据写入任务工作目录下的临时文件output/spillN.out(N表示当前溢写次数)中。如果用户设置了Combiner,则写入文件之前,对每个分区中的数据进行一次聚集操作。\
步骤3:将分区数据的元信息写到内存索引数据结构SpillRecord中,其中每个分区的元信息包括在临时文件中的偏移量、压缩前数据大小和压缩后数据大小。如果当前内存索引大小超过1MB,则将内存索引写到文件output/spillN.out.index中。\
(5)Combine阶段:当所有数据处理完成后,MapTask对所有临时文件进行一次合并,以确保最终只会生成一个数据文件。\
当所有数据处理完后,MapTask会将所有临时文件合并成一个大文件,并保存到文件output/file.out中,同时生成相应的索引文件output/file.out.index。\
在进行文件合并过程中,MapTask以分区为单位进行合并。对于某个分区,它将采用多轮递归合并的方式。每轮合并io.sort.factor(默认100)个文件,并将产生的文件重新加入待合并列表中,对文件排序后,重复以上过程,直到最终得到一个大文件。\
让每个MapTask最终只生成一个数据文件,可避免同时打开大量文件和同时读取大量小文件产生的随机读取带来的开销。
Map方法之后,Reduce方法之前的数据处理过程称之为Shuffle。

具体Shuffle过程详解:\
1)MapTask收集我们的map()方法输出的kv对,放到内存缓冲区中\
2)从内存缓冲区不断溢出本地磁盘文件,可能会溢出多个文件\
3)多个溢出文件会被合并成大的溢出文件\
4)在溢出过程及合并的过程中,都要调用Partitioner进行分区和针对key进行排序\
5)ReduceTask根据自己的分区号,去各个MapTask机器上取相应的结果分区数据\
6)ReduceTask会取到同一个分区的来自不同MapTask的结果文件,ReduceTask会将这些文件再进行合并(归并排序)\
7)合并成大文件后,Shuffle的过程也就结束了,后面进入ReduceTask的逻辑运算过程(从文件中取出一个一个的键值对Group,调用用户自定义的reduce()方法)
1)Partition分区\
要求将统计结果按照条件输出到不同文件中(分区)。比如:将统计结果按照手机归属地不同省份输出到不同文件中(分区)\
(1)默认Partition分区
| 1 | public class HashPartitioner<K, V> extends Partitioner<K, V> { |
| 2 | public int getPartition(K key, V value, int numReduceTasks) { |
| 3 | return (key.hashCode() & Integer.MAX_VALUE) % numReduceTasks; |
| 4 | } |
| 5 | } |
默认分区是根据key的hashCode对reduceTasks个数取模得到的。用户没法控制哪个key存储到哪个分区。\
(2)自定义Partition步骤\
a、自定义类继承Partitioner,重写getPartition()方法
| 1 | public class ProvincePartitioner extends Partitioner<Text, FlowBean> { |
| 2 | @Override |
| 3 | public int getPartition(Text key, FlowBean value, int numPartitions) { |
| 4 | //控制分区逻辑代码 |
| 5 | ...... |
| 6 | } |
| 7 | } |
b、在job驱动中,设置自定义partitioner\
job.setPartitionerClass(CustomPartitioner.class);\
c、自定义partition后,要根据自定义partitioner的逻辑设置相应数量的reduce task\
job.setNumReduceTasks(5);\
(3)总结\
a、如果reduceTask的数量> getPartition的结果数,则会多产生几个空的输出文件part-r-000xx;\
b、如果1<reduceTask的数量<getPartition的结果数,则有一部分分区数据无处安放,会Exception;\
c、如果reduceTask的数量=1,则不管mapTask端输出多少个分区文件,最终结果都交给这一个reduceTask,最终也就只会产生一个结果文件 part-r-00000;\
d、分区数必须从零开始,逐一累加。\
案例:假设自定义分区数为5,则\
(1)job.setNumReduceTasks(1); 会正常运行,只不过会产生一个输出文件\
(2)job.setNumReduceTasks(2); 会报错\
(3)job.setNumReduceTasks(6); 大于5,程序会正常运行,会产生空文件
2)排序\
排序是MapReduce框架中最重要的操作之一。Map Task和Reduce Task均会对数据按照key进行排序。该操作属于Hadoop的默认行为。任何应用程序中的数据均会被排序,而不管逻辑上是否需要。默认排序是按照字典顺序排序,且实现该排序的方法是快速排序。\
对于Map Task,它会将处理的结果暂时放到一个缓冲区中,当缓冲区使用率达到一定阈值后,再对缓冲区中的数据进行一次排序,并将这些有序数据写到磁盘上,而当数据处理完毕后,它会对磁盘上所有文件进行归并排序。\
对于Reduce Task,它从每个Map Task上远程拷贝相应的数据文件,如果文件大小超过一定阈值,则放到磁盘上,否则放到内存中。如果磁盘上文件数目达到一定阈值,则进行一次合并以生成一个更大文件;如果内存中文件大小或者数目超过一定阈值,则进行一次合并后将数据写到磁盘上。当所有数据拷贝完毕后,Reduce Task统一对内存和磁盘上的所有数据进行一次合并。\
排序分类:\
a、部分排序(区内排序——环形缓冲区)\
MapReduce根据输入记录的键对数据集排序。保证输出的每个文件内部排序。\
b、全排序\
最终输出结果只有一个文件,且文件内部有序。实现方式是只设置一个ReduceTask,但该方法在处理大型文件时效率极低,因为只有一台机器处理所有文件,完全丧失了MapReduce所提供的并行架构。\
c、辅助排序(GroupingComparator分组)\
在Reduce端对Key进行分组。应用于:在接受的key为bean对象时,想让一个或几个字段相同(全部字段不相同)的key进入到同一个reduce方法时,可以采用分组排序。\
d、二次排序\
在自定义排序过程中,如果compareTo中的判断条件为两个即为二次排序。
3)Combiner合并\
(1)combiner是MR程序中Mapper和Reducer之外的一种组件。\
(2)combiner组件的父类就是Reducer。\
(3)combiner和reducer的区别在于运行的位置:\
Combiner是在每一个maptask所在的节点运行;\
Reducer是接收全局所有Mapper的输出结果;\
(4)combiner的意义就是对每一个maptask的输出进行局部汇总,以减小网络传输量。\
(5)combiner能够应用的前提是不能影响最终的业务逻辑,而且,combiner的输出kv应该跟reducer的输入kv类型要对应起来。
1)ReduceTask工作机制

(1)Copy阶段:ReduceTask从各个MapTask上远程拷贝一片数据,并针对某一片数据,如果其大小超过一定阈值,则写到磁盘上,否则直接放到内存中。\
(2)Merge阶段:在远程拷贝数据的同时,ReduceTask启动了两个后台线程对内存和磁盘上的文件进行合并,以防止内存使用过多或磁盘上文件过多。\
(3)Sort阶段:按照MapReduce语义,用户编写reduce()函数输入数据是按key进行聚集的一组数据。为了将key相同的数据聚在一起,Hadoop采用了基于排序的策略。由于各个MapTask已经实现对自己的处理结果进行了局部排序,因此,ReduceTask只需对所有数据进行一次归并排序即可。\
(4)Reduce阶段:reduce()函数将计算结果写到HDFS上。
2)ReduceTask并行度(个数)\
ReduceTask的并行度同样影响整个Job的执行并发度和执行效率,但与MapTask的并发数由切片数决定不同,ReduceTask数量的决定是可以直接手动设置。\
默认值是1,可自己手动设置为4\
job.setNumReduceTasks(4);
1)OutputFormat接口实现类\
OutputFormat是MapReduce输出的基类,所有实现MapReduce输出都实现了 OutputFormat接口。以下是几种常见的OutputFormat实现类。\
a、文本输出TextOutputFormat\
默认的输出格式是TextOutputFormat,它把每条记录写为文本行。它的键和值可以是任意类型,因为TextOutputFormat调用toString()方法把它们转换为字符串。\
b、SequenceFileOutputFormat\
SequenceFileOutputFormat将它的输出写为一个顺序文件。如果输出需要作为后续 MapReduce任务的输入,这便是一种好的输出格式,因为它的格式紧凑,很容易被压缩。\
c、自定义OutputFormat\
根据用户需求,自定义实现输出。\
(1)自定义一个类继承FileOutputFormat。\
(2)改写recordwriter,具体改写输出数据的方法write()。
登录后可以选中正文添加批注(仅自己可见)。
评论 (0)
登录后参与评论。
还没有评论,来做第一个。