Spark
Spark 是一个基于内存的分布式计算引擎。相比于Hadoop自带的MapReduce计算框架,Spark优势明显。 Spark一方面提供了更加灵活丰富的数据操作方式,有些需要分解成几轮 MapReduce作业的操作,可以在 Spark里一轮实现; 另一方面,每轮的计算结果都可以分布式地存放在内存中,下一轮作业直接从内存中读取数据,节省大量磁盘IO开销。
- ResourceManger:处理客户端请求、启动和监控ApplicationMaster、监控NodeManager、资源的分配与调度
- NodeManger:管理单个节点上的资源、处理来自ResourceManager的命令、处理来自ApplicationMaster的命令
- ApplicationMaster:为应用程序申请资源
- Application:用户自己写的Spark应用程序,批处理作业的集合。Application的main方法为应用程序的入口,用户通过Spark的API,定义了RDD和对RDD的操作
- SparkContext:Spark最重要的API,用户逻辑与Spark集群主要的交互接口。
- Driver:主控进程。SparkContext运行在其中,负责产生DAG,提交Job,转化Task。
- Executor:负责执行Task,并将结果返回给Driver,同时也提供缓存的RDD的功能
- yarn-client模式driver端在本地,可以与集群进行调度和通讯,进行交互式作业。但如果作业很多则会造成client端压力很大。
- yarn-cluster模式driver运行在AM中,client提交完作业就可以关掉了,但无法进行交互式作业。
- 词法与语法分析:使用 ANTLR 等工具将输入的 SQL 字符串转换成抽象语法树(AST,即未解析的逻辑计划
Unresolved Logical Plan)。 - 检查元数据:利用
SessionCatalog结合元数据信息(如 Hive MetaStore 或内存中的表结构),对 AST 中的表名、字段名、函数名进行绑定和有效性校验,生成已解析的逻辑计划(Analyzed Logical Plan)。
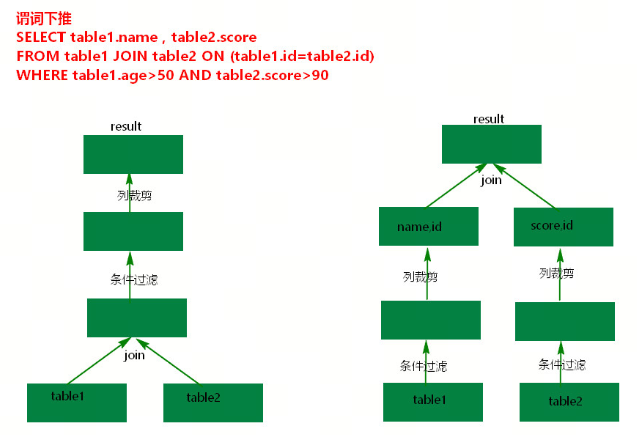
- 规则优化:Catalyst 优化器内置了大量的优化规则(Rule-based Optimization),如谓词下推(Predicate Pushdown)、列裁剪(Column Pruning)、常量折叠(Constant Folding)等。
- 代价优化:基于统计信息(Cost-based Optimization, CBO)评估不同的执行路径,调整连接顺序或选择更优的 Join 策略,最终输出优化的逻辑计划(
Optimized Logical Plan)。
- 生成物理计划:将优化后的逻辑计划转换成一个或多个物理计划(
Physical Plan),并通过贪心算法或 Cost 模型选择代价最低的物理执行策略(例如选择BroadcastHashJoin还是SortMergeJoin)。 - 准备执行:对物理算子进行进一步处理,比如插入必要的 Shuffle 算子(
Exchange)或行列转换操作。
Exchange算子是实现数据并行化的重要算子,用于解决数据分布(Distribution)相关问题。继承它的子类有两种:
- BroadcastExchange:广播操作。
- ShuffleExchange:通过shuffle进行重分区。
- 生成 Java 字节码:利用 Spark 的 Whole-Stage Code Generation(全阶段代码生成)技术,将整个物理计划编译成高效的 Java 字节码。
- 转为 RDD 执行:把编译好的代码包装在 RDD 的算子中,直接提交给底层的 Spark Core 调度运行,从而避开传统的解释执行开销,大幅提升计算性能。
RDD(弹性分布式数据集) 是 Spark 的基石,可以理解为一个分布在多台机器上的、只读的数据集合。
- 分区(Partition):数据被切成多个分区散落在不同节点,分区是并行计算的最小单位。
- 不可变:RDD 一旦创建就不能修改,任何转换都是生成一个新的 RDD。
- 血缘(Lineage):每个 RDD 都记得自己是怎么从上一个 RDD 算出来的。某个分区的数据丢了,不需要重算全部,顺着血缘把那个分区重新算一遍就行——这就是「弹性」的含义,也是 Spark 容错的核心机制。
1. Transformation 算子:通常用来将RDD内的元素进行转换,并返回一个新的RDD,它们只搭建管道,不执行计算
- map(func):对 RDD 中的每个元素应用一次函数,返回新 RDD。
- filter(func):过滤掉不符合条件的元素,返回新 RDD。
- flatMap(func):类似 map,但每个输入元素可以映射为 0 或多个输出元素。
- reduceByKey(func):针对 Key-Value 类型的数据,按照相同的 Key 来进行聚合。
- groupByKey():将 Key-Value 类型的数据按照 Key 进行分组。
2. Action 算子(行动):它们会触发真正的任务调度与运算:
- collect():将 RDD 的所有元素拉取到 Driver 端内存中,形成一个普通集合。
- count():返回 RDD 中元素的总个数。
- reduce(func):在驱动程序中对数据集中的元素进行聚合计算。
- first():返回 RDD 中的第一个元素。
- saveAsTextFile(path):将数据集中的元素保存到文本文件或 HDFS 中。
| 1 | Application(一个 Spark 程序) |
| 2 | └─ Job(一个 Action 触发一个 Job) |
| 3 | └─ Stage(按宽依赖切分) |
| 4 | └─ Task(一个分区对应一个 Task,最小执行单元) |
Stage 怎么切分,取决于依赖类型:
- 窄依赖:父 RDD 的每个分区最多被一个子分区使用(如
map、filter)。不需要跨节点传数据,可以在同一个 Stage 里连续执行。 - 宽依赖:父 RDD 的一个分区被多个子分区使用(如
groupByKey、join)。必须做 Shuffle,因此成为 Stage 的分界线。
所以一句话:遇到宽依赖就断开,切出一个新 Stage。Stage 越多意味着 Shuffle 越多,调优的方向往往就是想办法减少宽依赖。
Driver 是 Spark 应用的大脑。它负责:
- 解析 SQL / 代码,生成执行计划
- 划分 Job、Stage、Task
- 向集群申请资源
- 调度 Task 到 Executor 上执行
- 收集任务状态和部分结果
Executor 是真正干活的进程。它负责:
- 执行 Driver 分配过来的 Task
- 缓存数据
- Shuffle 读写
- 向 Driver 汇报状态
Core 决定 Executor 的并发能力。一般来说:1 个 core 同一时间通常跑 1 个 task,例如:
- executor-cores = 4
- num-executors = 10
- 那么总并发 Task 数大约是:4 \* 10 = 40
Task 是 Spark 最小执行单元。
- 一个 Stage 会被拆成多个 Task,通常和分区数对应。
- 一个 partition 通常对应一个 task,如果某个 Stage 有 200 个分区,就会有约 200 个 Task。
队列 是集群资源池,比如 Yarn 队列。队列决定你的 Spark 应用最多能拿到多少:
- CPU
- Memory
- Executor 数
- 并发资源
所以队列是上限,Spark 参数是在这个上限内分配资源。
CPU ≈ executor 数 \* executor cores
Memory ≈ executor 数 \* executor memory
并发 task 数 ≈ executor 数 \* executor cores
spark.driver.memory=12G:driver的堆内存spark.driver.cores:driver的core数spark.driver.memoryOverhead=6144:driver的堆外内存
spark.vcore.boost.ratio=2(原spark.vcore.boost=2),一个core来跑两个task,提高cpu利用率。如果shuffle很重,那么就需要看shuffle write/read 指标来调节内存大小。spark.executor.memory=8G:每个executor的堆内存大小。风神默认5g。spark.executor.cores=4:每个executor的核数,默认1个core运行1个task。风神默认3个spark.executor.memoryOverhead=6144:每个executor的堆外内存,默认取max(384MB,spark.executor.memory \*0.1),dorado默认6G,风神默认3G
spark.dynamicAllocation.enabled=true,开启参数spark.dynamicAllocation.minExecutors=5,executor最小申请个数spark.dynamicAllocation.maxExecutors=900,executor最大申请个数spark.dynamicAllocation.initialExecutors=5,初始申请executor个数,默认等于minExecutorsspark.dynamicAllocation.executorIdleTimeout=120s,一个executor空闲超过该参数时,自动释放资源spark.dynamicAllocation.schedulerBacklogTimeout(默认1秒),如果有task pending超过该参数,开启资源申请spark.dynamicAllocation.sustainedSchedulerBacklogTimeout(默认等于上面的参数),当pending task存在以后,每隔该参数进行一个资源的申请(如果资源有,会以1、2、4、8指数的申请)spark.shuffle.service.enabled=true,在不删除由executors产生的shuffle文件的情况下删除executors
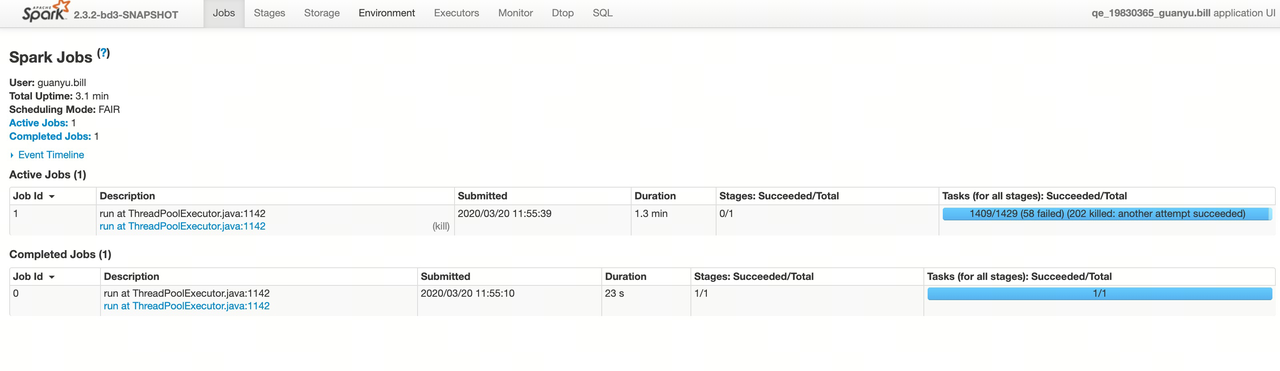
在浏览器中打开tracking URL后,默认进入Jobs页。Jobs展示的是整个spark应用任务的job整体信息:
- User: spark任务提交的用户,用以进行权限控制与资源分配。
- Total Uptime: spark application总的运行时间,从appmaster开始运行到结束的整体时间。
- Scheduling Mode: application中task任务的调度策略,由参数spark.scheduler.mode来设置,可选的参数有FAIR和FIFO,我司默认是FAIR。这与yarn的资源调度策略的层级不同,yarn的资源调度是针对集群中不同application间的,而spark scheduler mode则是针对application内部task set级别的资源分配。yarn 的FAIR模型是一种公平模型,相当于每个任务轮换使用资源等,这样能使的小job能很快执行,而不用等大job完成才执行了。
- Completed Jobs: 已完成Job的基本信息,如想查看某一个Job的详细情况,可点击对应Job进行查看。
- Active Jobs: 正在运行的Job的基本信息。
- Event Timeline: 在application应用运行期间,Job和Exector的增加和删除事件进行图形化的展现。这个就是用来表示调度job何时启动何时结束,以及Excutor何时加入何时移除。我们可以很方便看到哪些job已经运行完成,使用了多少Excutor,哪些正在运行。
Job默认都是串行提交运行的,如果Job间没有依赖,可以使用多线程并行提交Job,实现Job并发。
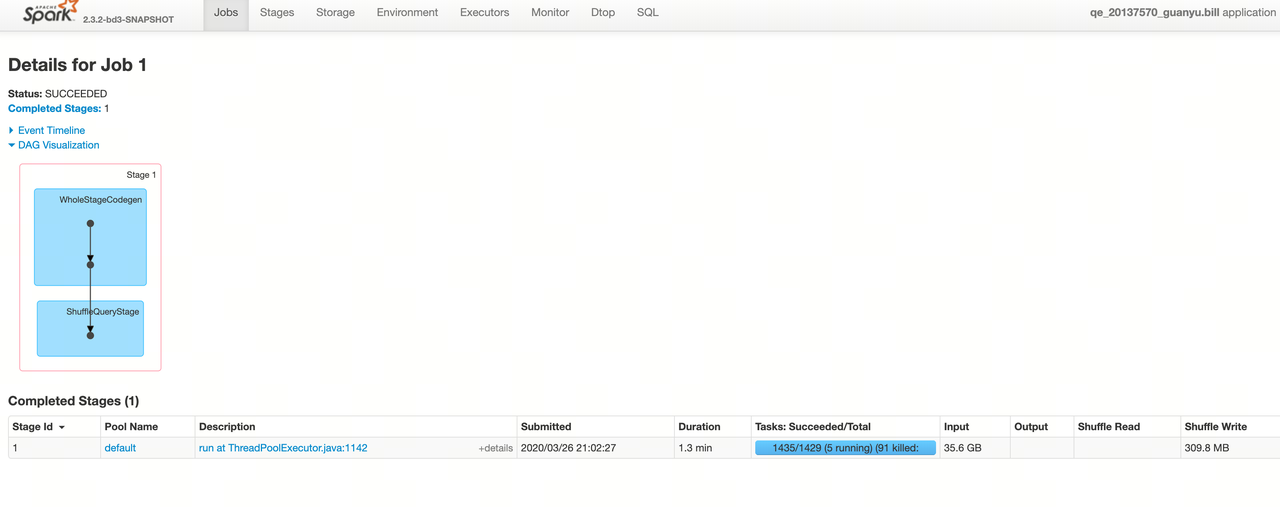
在Jobs页面点击进入某个Job之后,可以查看某一Job的详细信息:
- Status: 展示Job的当前状态信息。
- Active Stages: 正在运行的stages信息,点击某个stage可进入查看具体的stage信息。
- Pending Stages: 排队的stages信息,根据解析的DAG图stage可并发提交运行,而有依赖的stage未运行完时则处于等待队列中。
- Completed Stages: 已经完成的stages信息。
- Event Timeline: 展示当前Job运行期间stage的提交与结束、Executor的加入与退出等事件信息。
- DAG Visualization: 当前Job所包含的所有stage信息(stage中包含的明细的tranformation操作),以及各stage间的DAG依赖图。DAG也是一种调度模型,在spark的作业调度中,有很多作业存在依赖关系,所以没有依赖关系的作业可以并行执行,有依赖的作业不能并行执行
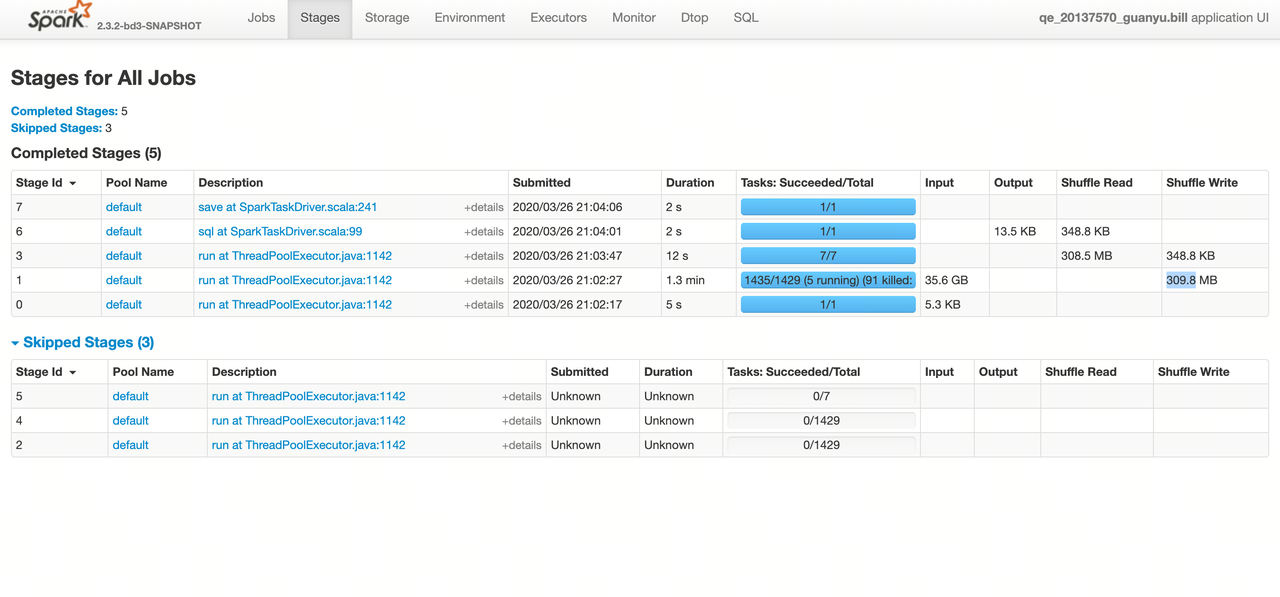
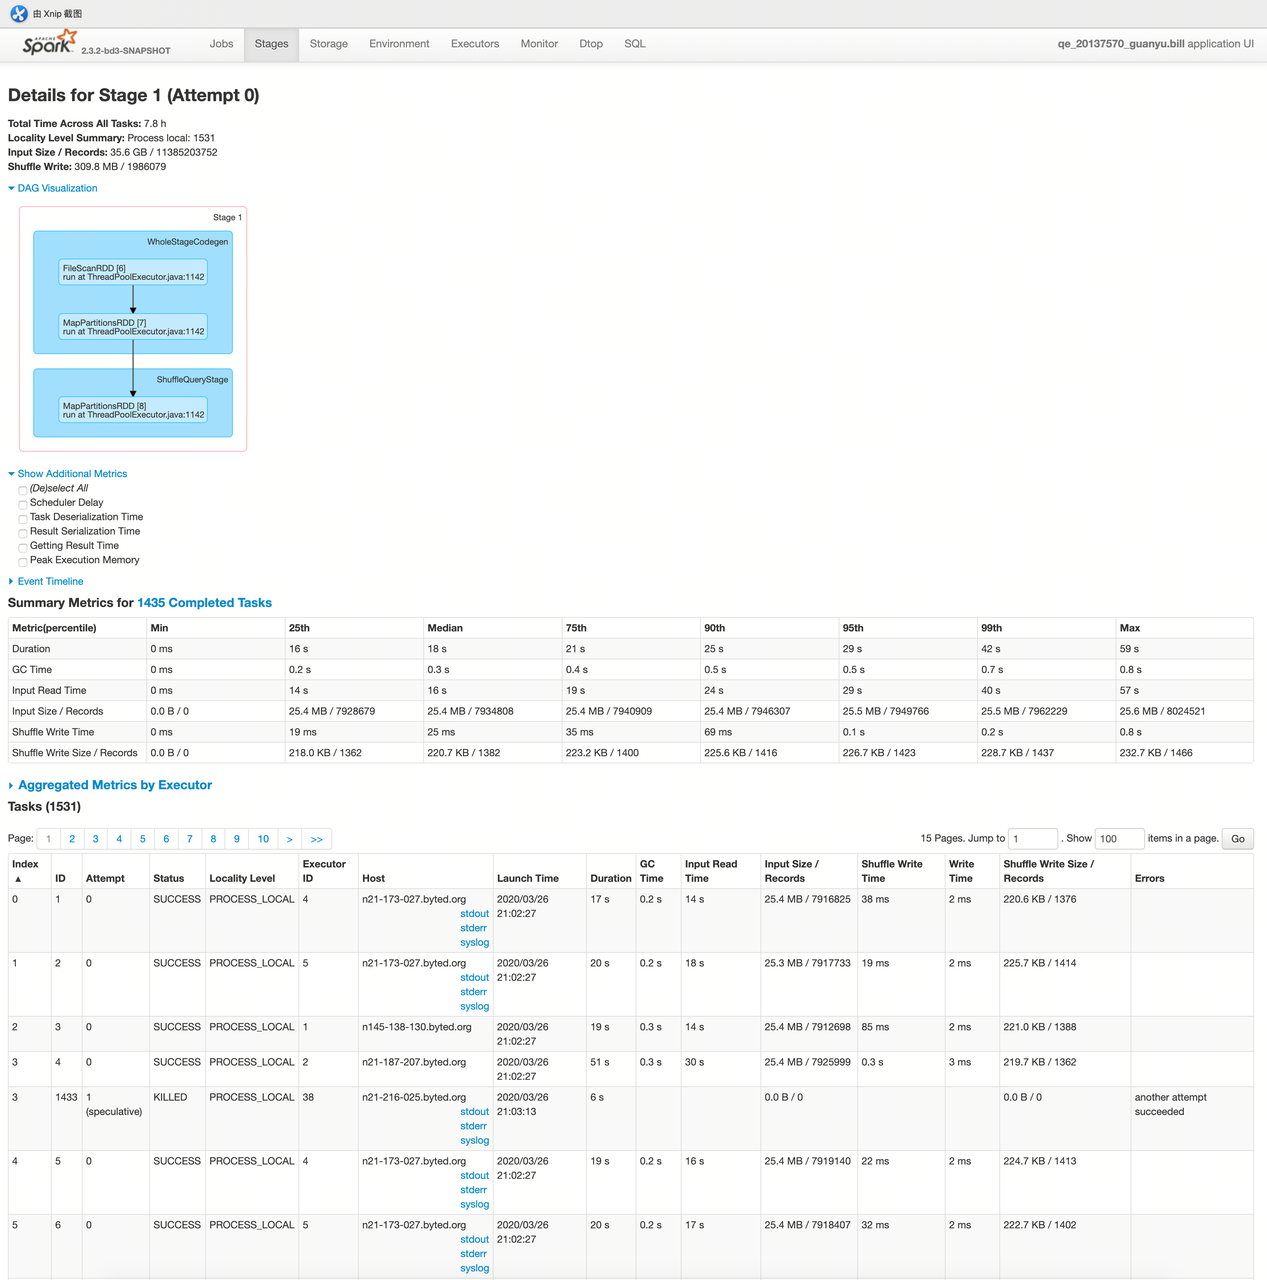
在Job Detail页点击进入某个stage后,可以查看某一stage的详细信息:
- Total time across all tasks: 当前stage中所有task花费的时间和。
- Locality Level Summary: 不同本地化级别下的任务数,本地化级别是指数据与计算间的关系。
- Input Size/Records: 输入的数据字节数大小/记录条数。这里可以通过参数控制任务初始并行度。
- Output Size / Records: 输出的数据字节数大小/记录条数。
- Shuffle Write: 为下一个依赖的stage提供输入数据,shuffle过程中通过网络传输的数据字节数/记录条数。应该尽量减少shuffle的数据量及其操作次数,这是spark任务优化的一条基本原则。
- Shuffle read:总的shuffle字节数,包括本地节点和远程节点的数据
- DAG Visualization: 当前stage中包含的详细的tranformation操作流程图。
- Show Additional Metrics:显示额外的一些指标。鼠标移上去会有相应的解释。
- Event Timeline: 清楚地展示在每个Executor上各个task的各个阶段的时间统计信息,可以清楚地看到task任务时间是否有明显倾斜,以及倾斜的时间主要是属于哪个阶段,从而有针对性的进行优化。
- Summary Metrics for XXX Completed Tasks:已完成的Task的指标摘要。
- Duration:task持续时间
- GC Time:task gc消耗时间
- Output Write Time:输出写时间
- Output Size/ Records : 输出数量大小,条数。
- Shuffle HDFS Read Time: shuffle中间结果从hdfs读取时间
- Shuffle Read Size/Records: shuffle 读入数据大小/条数
- Shuffle Spill Time: shuffle 中间结果溢写时间。
- Shuffle spill (memory):shuffle 溢写使用的内存大小。
- Shuffle spill (disk):shuffle 溢写使用的硬盘大小。
- Aggregated Metrics by Executor: 汇总指标。将task运行的指标信息按executor做聚合后的统计信息,并可查看某个Excutor上任务运行的日志信息。这里可以看到executor完成task的情况,读入的数据量,shuffle write、shuffle read 数据量,根据这些指标判断节点是否健康。
- Tasks: 当前stage中所有任务运行的明细信息。右边部分都是需要关注的点。
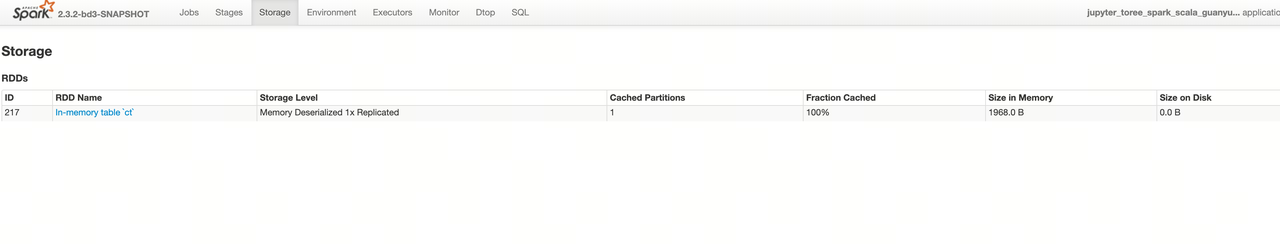
storage页面能看出application当前使用的缓存情况,可以看到有哪些RDD被缓存了,以及占用的内存资源。如果job在执行时持久化(persist)/缓存(cache)了一个RDD,那么RDD的信息可以在这个选项卡中查看。
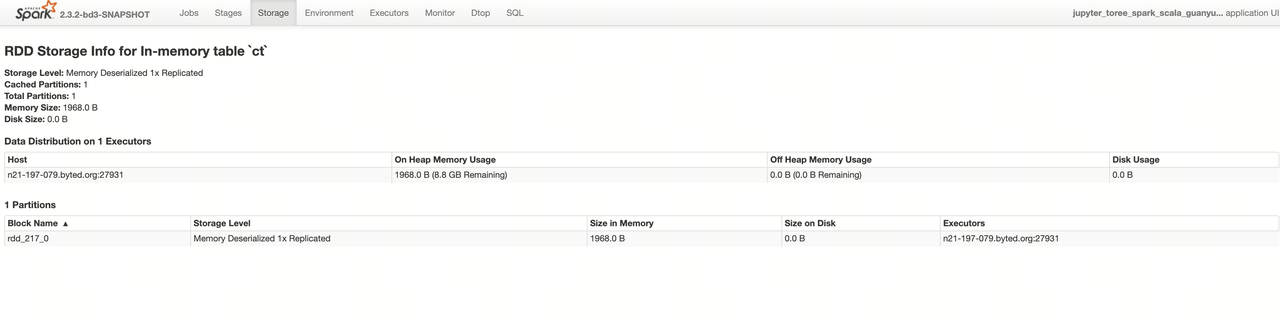
点击某个RDD即可查看该RDD缓存的详细信息,包括缓存在哪个Executor中,使用的block情况,RDD上分区(partitions)的信息以及存储RDD的主机的地址。
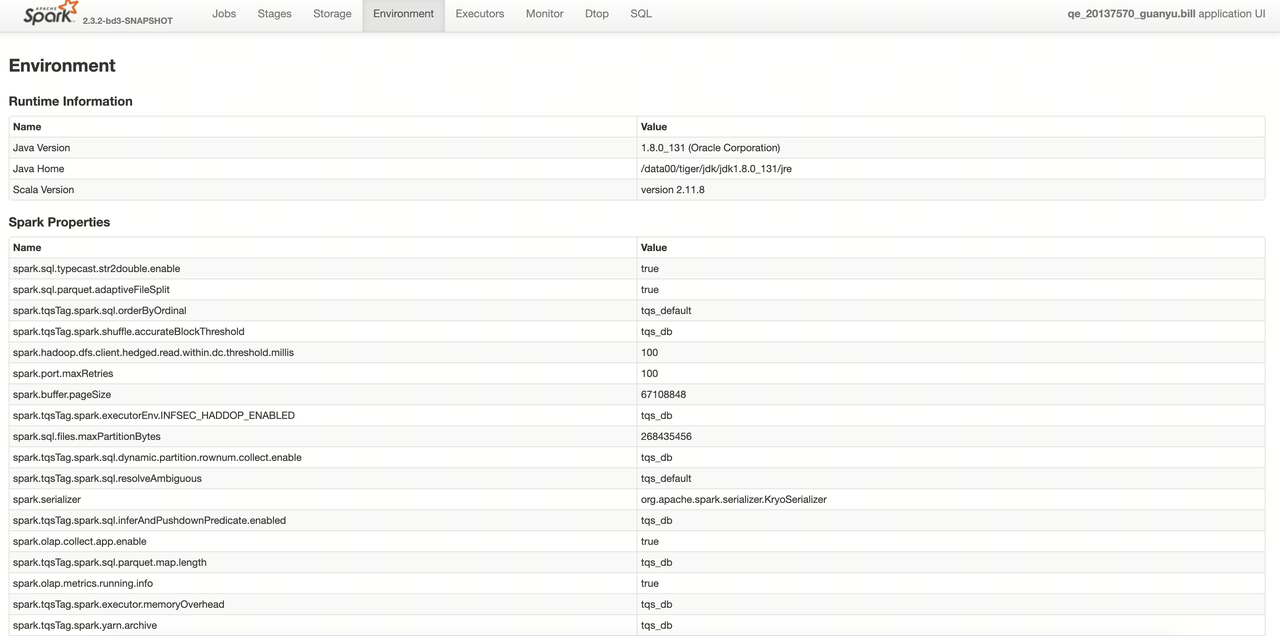
Environment选项卡提供有关Spark应用程序(或SparkContext)中使用的各种属性和环境变量的信息。用户可以通过这个选项卡得到非常有用的各种Spark属性信息,而不用去翻找属性配置文件。通过平台工具提交任务时,其默认参数配置可以在这里查找。
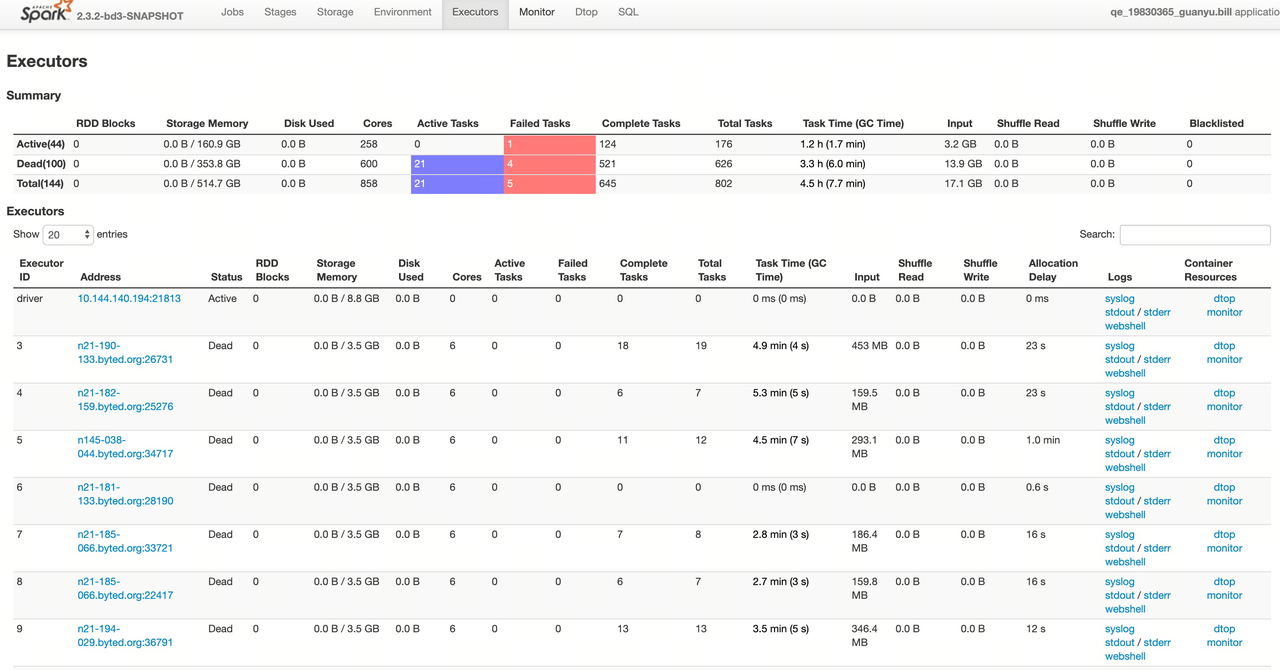
Executors选项卡提供了关于内存、CPU核和其他被Executors使用的资源的信息。这些信息在Executor级别和汇总级别都可以获取到。一方面通过它可以看出来每个excutor是否发生了数据倾斜,另一方面可以具体分析目前的应用是否产生了大量的shuffle,是否可以通过增加并行度来减少shuffle的数据量。
- Summary: 该application运行过程中使用Executor的统计信息。
- Executors: 每个Excutor的详细信息(包含driver),可以点击查看某个Executor中任务运行的详细日志。
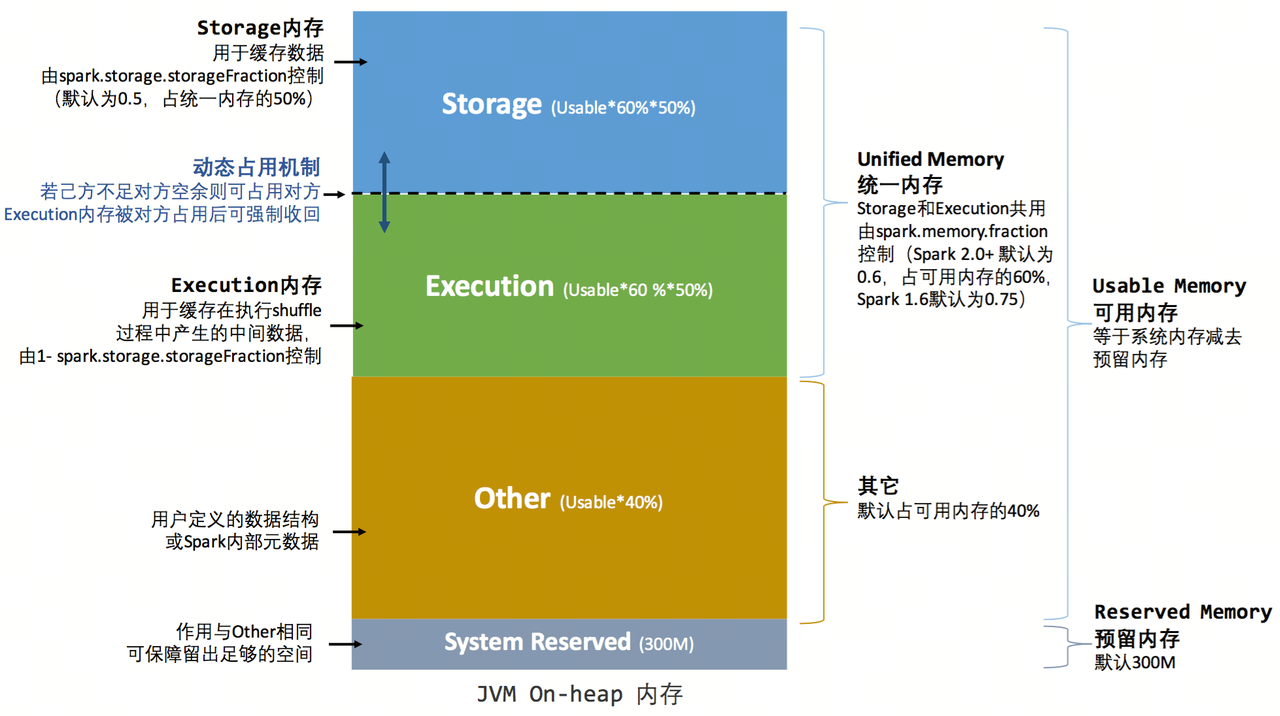
spark.memory.fraction=0.6统一内存占比。在shuffle很重、内存很大的情况下可以适当调大该参数。
登录后可以选中正文添加批注(仅自己可见)。
评论 (0)
登录后参与评论。
还没有评论,来做第一个。