数据结构
一、定义
数据结构是组织和管理数据的方式,以便有效地访问和处理数据。
二、原理
- 线性结构:数据元素一对一的线性关系,如数组、链表。
- 非线性结构:数据元素之间存在一对多或多对多的关系,如树、图。
- 抽象数据类型:通过抽象数据类型(ADT)定义数据结构和操作,如栈、队列、集合。
三、关键点
- 时间复杂度:描述算法执行时间与数据规模的关系。
- 空间复杂度:描述算法执行所需存储空间与数据规模的关系。
- 数据访问效率:根据数据结构的特点,选择合适的数据访问方式。
四、常见的数据结构及其区别
1. 数组与链表的区别
| 特性 | 数组 | 链表 |
|---|---|---|
| 内存分配 | 固定大小,连续内存空间 | 动态大小,非连续内存,节点通过指针连接 |
| 访问 | 支持随机访问,通过索引快速访问元素,时间复杂度O(1) | 不支持随机访问,顺序访问,访问任何元素都需要O(n)时间复杂度 |
| 插入/删除 | O(n),因为需要移动元素 | 在已知节点位置的情况下O(1) |
| 大小 | 固定大小,扩容复杂 | 动态大小,容易扩展 |
| 使用场景 | 数据量固定,频繁查找 | 数据量变化大,频繁插入和删除 |
code
| 1 | 数组: [ 1 ][ 2 ][ 3 ][ 4 ][ 5 ] |
| 2 | ^ ^ ^ ^ ^ |
| 3 | 0x00 0x04 0x08 0x0C 0x10 <- 内存地址(示例) |
| 4 | |
| 5 | 链表: [ 1 ] -> [ 2 ] -> [ 3 ] -> [ 4 ] -> [ 5 ] -> NULL |
| 6 | ^ ^ ^ ^ ^ |
| 7 | 0x00 0x08 0x15 0x21 0x35 <- 内存地址(示例) |
2. 栈和队列的区别
| 结构 | 栈(Stack) | 队列(Queue) |
|---|---|---|
| 特性 | LIFO(先进后出) | FIFO(先进先出) |
| 使用场景 | 用于解决如递归、回溯等问题。 | 用于缓存、任务排队等场景。 |
| 操作 | push(),pop(),查看顶元素。 | enqueue(),dequeue(),查看前端元素。 |
code
| 1 | 栈: [ 4 ] |
| 2 | [ 3 ] |
| 3 | [ 2 ] <- top (pop/push) |
| 4 | [ 1 ] |
| 5 | |
| 6 | 队列: front -> [ 1 ] -> [ 2 ] -> [ 3 ] -> [ 4 ] -> rear (enqueue at rear, dequeue from front) |
3. 二叉树的遍历方法
基础概念
- 前序遍历:根 - 左 - 右
- 中序遍历:左 - 根 - 右
- 后序遍历:左 - 右 - 根
- 层次遍历:按层遍历树结构,通常使用队列实现。
code
| 1 | [ 1 ] |
| 2 | / \ |
| 3 | [ 2 ] [ 3 ] |
| 4 | / \ \ |
| 5 | [ 4 ] [ 5 ] [ 6 ] |
| 6 | |
| 7 | 前序遍历: 1 2 4 5 3 6 |
| 8 | 中序遍历: 4 2 5 1 6 3 |
| 9 | 后序遍历: 4 5 2 6 3 1 |
4. 图的表示方法
基础概念
- 邻接矩阵:二维数组,适合表示密集图。
- 邻接列表:链表数组,适合表示稀疏图。
- 选择方法基于图的稠密或稀疏程度以及频繁执行的操作类型。
示意图
code
| 1 | 图:0 --- 1 |
| 2 | |
| 3 | 邻接矩阵: |
| 4 | 0 1 |
| 5 | 0 [ 0, 1 ] |
| 6 | 1 [ 1, 0 ] |
| 7 | |
| 8 | 邻接列表: |
| 9 | 0 -> [ 1 ] |
| 10 | 1 -> [ 0 ] |
5. 哈希表的工作原理及碰撞解决办法
工作原理:使用哈希函数将键转换为数组索引。
碰撞解决:
- 链地址法:每个桶存储一个链表。
- 开放地址法:发现碰撞时,寻找下一个空闲的桶。
- 双散列:使用两个哈希函数。
code
| 1 | 哈希表数组: [ ][ ][ ][ ] -> [ key: "apple", value: 5 ] |
| 2 | 链地址法解决冲突: |
| 3 | [ ][ ][ ][ ] -> [ "apple", 5 ] -> [ "banana", 3 ] -> NULL |
6. 动态规划与贪心算法的区别
- 动态规划:将复杂问题分解为小问题,解决小问题后,用这些解构建大问题的解。适用于有重叠子问题和最优子结构的问题。
- 贪心算法:在每一步选择中都采取在当前状态下最好或最优(即最有利)的选择,从而希望导致结果是全局最好或最优的解答。
示意图
code
| 1 | 动态规划:构建解决方案的 "决策树" 并使用备忘录 (memoization) |
| 2 | 20 |
| 3 | / \ |
| 4 | 11 9 |
| 5 | / \ ... |
| 6 | 5 6 |
| 7 | |
| 8 | 贪心算法:选择每一步的局部最优解,不回溯 |
| 9 | 20 |
| 10 | \ |
| 11 | 9 |
| 12 | \ |
| 13 | ... |
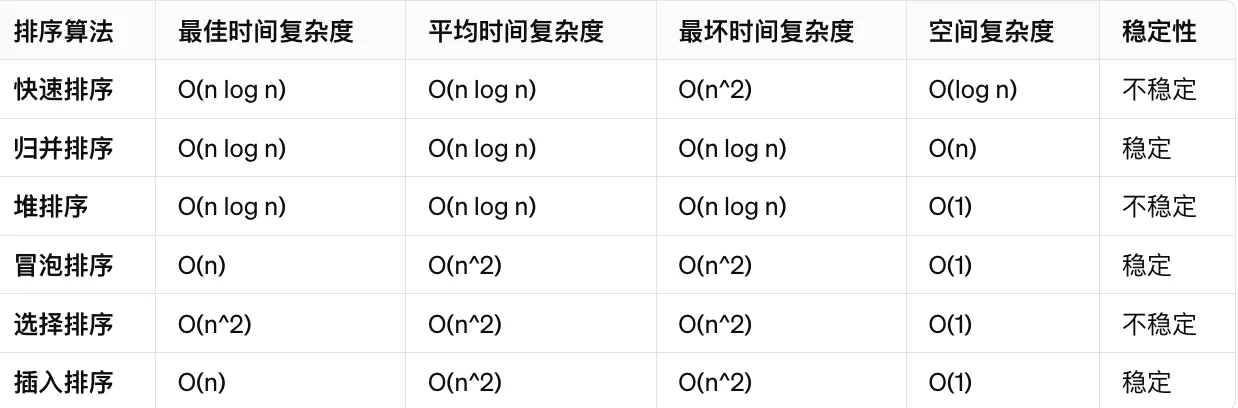
7. 常见的排序算法及其复杂度
8. 什么是红黑树?
- 一种自平衡二叉搜索树。
- 每个节点包含一个颜色属性(红或黑)。
- 设计这种结构的目的是在插入和删除操作后,通过旋转和重新着色以保持树的平衡。
code
| 1 | 红黑树示例: |
| 2 | [B]10 |
| 3 | / \ |
| 4 | [R]5 [R]20 |
| 5 | / \ / \ |
| 6 | [B]3 [B]7 [B]15 [B]30 |
9. 解释B树和B+树的区别
- B树:一种平衡的多路搜索树,常用于数据库索引。
- B+树:B树的变种,所有值都存在叶子节点,内部节点只存储键的副本,广泛用于数据库和操作系统的文件系统。
code
| 1 | B树结构: B+树结构: |
| 2 | [20] [20] |
| 3 | / \ / \ |
| 4 | [10] [30] [10] [30] |
| 5 | / \ / \ |
| 6 | [5,10] [20,30] [40] |
10. 什么是AVL树?
- 左子树和右子树的高度差绝对不超过1
- 插入或删除节点后,通过左旋、右旋等操作来保持树的平衡
- 时间复杂度:对于插入、删除和查找操作,时间复杂度均为O(log n)
code
| 1 | AVL树示例: |
| 2 | 30 |
| 3 | / \ |
| 4 | 20 40 |
| 5 | / \ |
| 6 | 10 25 |
登录后可以选中正文添加批注(仅自己可见)。
评论 (0)
登录后参与评论。
还没有评论,来做第一个。